
이번 자료에서 권할 만한 구성은 이미지 판단이 필요할 때 Jev를 먼저 쓰고 보류한 경우에만 현재 모델로 보완하는 방식이다. 버튼 이름이나 페이지 구조로 대상을 정확히 고를 수 있다면 그 방법을 먼저 쓴다.
Jev는 AI 브라우저 자동화에서 무슨 역할을 할까
이 실험에서 Jev는 화면 이미지를 보고 원하는 대상이 있는지, 어디를 눌러야 하는지 찾는다. 글자 없이 별 모양만 있는 버튼처럼 눈으로 구분해야 하는 대상을 떠올리면 된다.
매번 큰 AI 모델에 화면 판단을 맡기는 대신 Jev가 먼저 처리하고 확신하지 못할 때 작업 중이던 Claude나 Codex에 넘긴다. 안내 데스크에서 해결할 수 있는 문의는 바로 처리하고 어려운 문의만 담당자에게 넘기는 것과 비슷하다.
찾은 위치를 바로 누르지는 않는다. 클릭할 수 있는 지점인지 살피고 표시한 위치가 맞는지 다시 확인한다. 확인을 통과해야 클릭하며 이후에는 원하는 화면 결과가 나타났는지 살핀다. 확인하지 못하면 중단한다.
버튼 이름이나 페이지 구조로 대상을 고를 수 있으면 먼저 그 방법을 쓴다.
이미지 판단이 필요하면 Jev가 대상을 찾는다.
Jev가 보류한 경우에만 현재 모델이 위치를 찾고 확인한다.
어느 경로든 클릭 전후 확인을 유지한다.
이번 비교는 이 중 이미지로 클릭 위치를 판단하는 경로를 시험했다. 이름이나 페이지 구조로 클릭하는 경로의 효과까지 측정한 것은 아니다.
어떤 모델과 조건으로 비교했나
브라우저 조작은 ego-browser, Mac 앱 창 조작은 computer-use로 나눴다. 실제 서비스의 긴 업무 절차 대신 로컬 웹 화면과 앱 시험 창에서 대상 클릭과 없는 대상의 클릭 거부를 확인했다.
비교한 방식은 Claude 직접 사용, Codex 직접 사용, Jev 단독, Jev + Claude, Jev + Codex다. 혼합 방식은 Jev가 보류할 때 같은 모델이 보완한다. 직접 모델 방식에도 공통 안전 확인을 적용했다.
모델은 보고서에 기록된 Claude Opus 5.5와 Codex GPT-6.1-sol이다. 두 모델 모두 추론 설정은 Max였으며 요금제를 비교한 것이 아니다. 아래 결과는 Claude와 Codex의 순위가 아닌, 같은 모델에서 Jev를 먼저 썼을 때의 차이다.
브라우저 처리 시간과 호출 비용은 얼마나 줄었나
웹 대상 8개를 방식마다 2회씩 시도했다. 한 방식당 16회, 다섯 방식을 합쳐 80회다. 다음 표는 직접 사용에서 Jev 우선 + 같은 모델 보완으로 바꾼 결과다.
비교 항목 | Claude 직접 → Jev + Claude | Codex 직접 → Jev + Codex |
|---|---|---|
목표 클릭 성공 | 16/16 → 16/16 | 16/16 → 16/16 |
시도당 평균 처리 시간 | 10.65초 → 4.39초 | 12.90초 → 5.40초 |
시간 감소율 | 58.8% | 58.1% |
16회 호출 비용 합계 | 717.87원 → 121.94원 | 1,045.47원 → 304.40원 |
비용 감소율 | 83.0% | 70.9% |
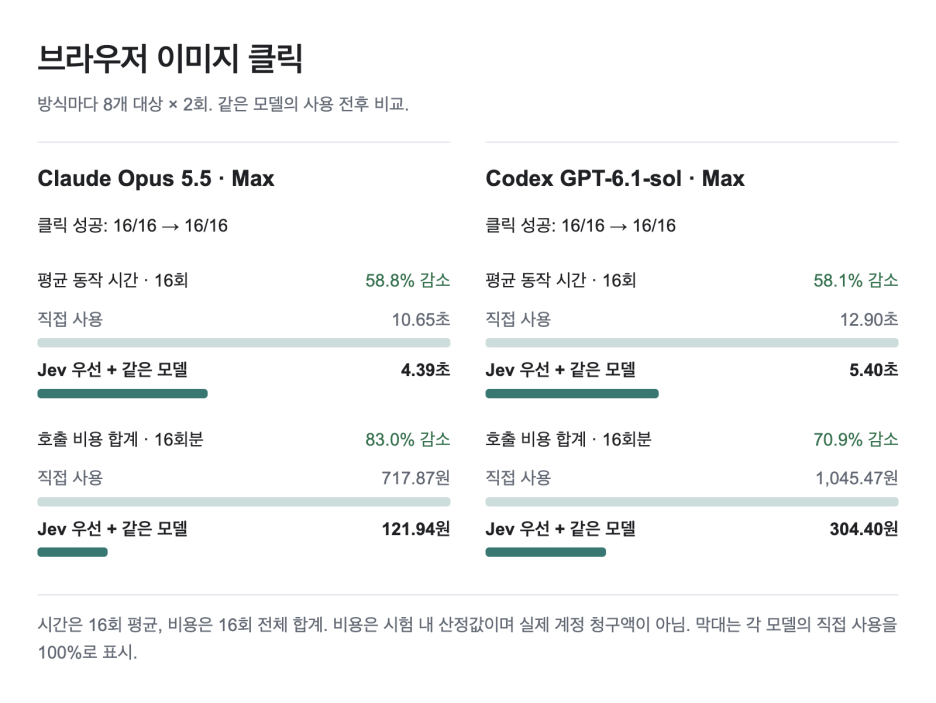
시간은 안전 확인과 모델 호출을 포함한 동작 처리 시간이다. 실패한 시도도 평균에 포함한다. 비용은 클릭 한 번이 아닌 16회 전체 호출의 합계이며 혼합 방식에는 Jev와 현재 모델의 비용을 모두 더했다.
Jev 단독은 시도당 평균 1.64초, 전체 호출 비용 14.78원으로 더 가벼웠지만 목표 클릭 성공은 12/16이었다. 이 평균에는 완료하지 못한 4회도 포함된다. 미완료 4건은 잘못 클릭한 사례로 집계되지 않았다.
혼합 방식은 두 모델 모두 4회씩 보완에 나서 16회 모두 클릭에 성공했다. 현재 모델 호출은 각각 32회에서 8회로 줄었다. 위치 찾기와 클릭 전 확인에 여러 호출이 들어가므로 클릭 횟수와 모델 호출 횟수는 다르다. Jev 호출은 따로 추가돼 전체 API 호출이 같은 비율로 줄었다고 볼 수도 없다.
이번 시험에서는 큰 모델을 빼기보다 필요한 경우에만 부르는 구성이 유리했다. 같은 웹 대상 8개를 두 번씩 시험한 16/16을 모든 사이트의 성공률 100%로 확대할 수는 없다.
앱 자동화에서도 같은 효과가 있었을까
computer-use는 방식마다 정상적인 별 대상 2회와 의도적으로 없는 대상 2회를 요청했다. 방식별 4회, 전체 20회다.
비교 항목 | Claude 직접 → Jev + Claude | Codex 직접 → Jev + Codex |
|---|---|---|
정상 대상 클릭 성공 | 1/2 → 2/2 | 1/2 → 2/2 |
정상 대상 평균 처리 시간 | 77.34초 → 6.38초 | 29.04초 → 6.56초 |
시간 감소율 | 91.7% | 77.4% |
4회 호출 비용 합계 | 492.71원 → 20.47원 | 569.07원 → 45.10원 |
비용 감소율 | 95.8% | 92.1% |
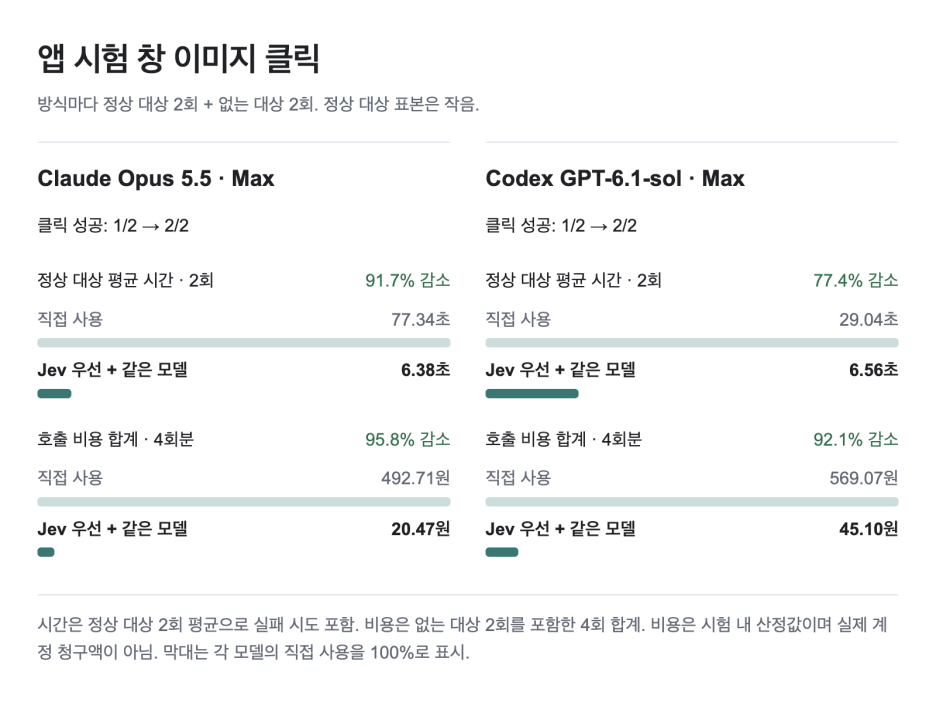
앱 표에서 시간과 비용의 분모는 다르다. 시간은 실패 시도를 포함한 정상 대상 2회 평균이며 비용은 없는 대상 2회까지 더한 4회 합계다.
정상 대상에서 시간 차이는 컸지만 방식마다 두 번뿐이다. 직접 Claude의 실패는 화면이 바뀌어 중단된 경우였고 직접 Codex의 실패는 창이 사라져 클릭 전달 여부를 확인하지 못한 경우였다. 전부 위치 판단 실수로 볼 수는 없다.
혼합 방식의 정상 대상 시도는 모두 Jev 단계에서 처리됐다. 따라서 이 시험만으로 앱에서 Jev가 자연스럽게 보류한 뒤 현재 모델이 복구하는 성능까지 확인했다고 말하기는 어렵다.
없는 대상은 모든 방식이 2회 모두 클릭을 거부했다. 누를 대상이 없을 때는 누르지 않는 것이 올바른 동작이다. 원 요청의 클릭 성공만 세면 혼합도 2/4지만 나머지 두 건은 없는 대상을 요청한 검사다.
없는 대상을 확인할 때는 혼합 방식이 오히려 느렸다. Claude는 직접 사용 5.71초에서 혼합 7.80초로, Codex는 7.32초에서 8.59초로 늘었다. Jev 보류 뒤 현재 모델을 추가로 호출했기 때문이다. 앱 자동화가 언제나 빨라진다고 볼 근거는 부족하다.
이 결과를 실제 업무에 적용하기 전에
비용은 실제 청구서가 아닌 시험 내 호출 비용이다. Claude는 CLI라는 실행 도구가 반환한 비용을 썼고 Jev와 Codex는 기록된 사용량에 당시 공개 단가를 적용했다. 확인되지 않은 실제 청구액을 0원으로 계산한 것이 아니다.
원화 환산은 2026년 10월 16일 기준 1달러당 1,334.03원을 사용했다. 공개 단가는 2026년 10월 25일 확인값이다. 준비·초기화 시간과 작업을 지시한 상위 AI 세션 비용은 비교 범위에서 제외했다.
보고서의 보조 시험에서는 새 세션의 스킬 자동 선택과 현재 모델 판단 경로를 각각 4/4로 확인했다. 복구 경로는 첫 Jev 응답을 보류로 바꿔 의도적으로 시험했다. 이후 모델 판단, 클릭 전 확인, 실제 클릭과 결과 확인은 실제로 실행했다.
이 보조 시험에는 Jev 미사용 대조군이 없어 성능 비교에 합산하지 않았다. 보고된 회귀 검사 51/51과 저장소 검사 6/6 통과도 구현 점검 결과다. 자연 발생 실패의 복구율이나 모든 서비스의 안정성을 입증한 수치는 아니다.
자주 묻는 질문
Jev만 사용해도 Claude나 Codex를 대체할 수 있나요?
이 시험만으로는 그렇게 결론 낼 수 없다. 브라우저에서 Jev 단독은 12/16, Jev가 보류할 때 같은 모델이 보완한 두 혼합 방식은 각각 16/16이었다. 이름이나 페이지 구조로 정확히 대상을 고를 수 있으면 그 경로를 먼저 쓰고, 이미지 판단이 필요할 때 Jev와 보완 모델을 함께 두는 구성이 원문 결과에 맞는다.
비용 절감률은 클릭 한 번의 비용이나 실제 청구서 기준인가요?
아니다. 브라우저 비용은 방식별 16회 호출 비용의 합계다. Claude 직접 사용 717.87원에서 혼합 121.94원, Codex 직접 사용 1,045.47원에서 혼합 304.40원으로 줄었다. 혼합에는 Jev와 보완 모델 비용을 모두 포함했다. 원문은 Claude CLI 반환 비용과 Jev·Codex 기록 사용량에 공개 단가를 적용했으며 준비·초기화와 상위 AI 세션 비용은 제외했다.
앱 자동화도 항상 빨라지고 4회 모두 클릭에 성공했나요?
아니다. 앱의 정상 대상 클릭은 직접 방식이 각각 1/2, 혼합 방식이 각각 2/2였다. 나머지 2회는 의도적으로 없는 대상을 요청한 검사로 모든 방식이 클릭을 거부했다. 정상 대상 평균 시간과 4회 전체 비용을 혼동하면 안 된다. 없는 대상 확인은 Claude 5.71초→7.80초, Codex 7.32초→8.59초로 혼합이 더 느렸다.
결론은 Jev 우선과 현재 모델 보완
이번 소규모 로컬 브라우저 시험에서는 Jev를 먼저 쓰고 보류할 때 현재 모델이 보완하는 방식이 같은 모델을 바로 쓰는 방식보다 평균 처리 시간과 시험 내 호출 비용을 줄였다. 앱 결과도 같은 방향이었지만 정상 대상은 방식마다 두 번뿐이고 없는 대상의 확인은 오히려 느렸다.
실제 적용 전에는 자주 쓰는 화면에서 정상 대상 클릭과 없는 대상의 클릭 거부를 나눠 여러 번 측정하는 편이 좋다. 성공 횟수뿐 아니라 실패 시도의 시간, 추가 모델 호출, 비용 범위도 함께 기록한다. 클릭 전후 확인은 유지한다.
기록 범위: 2026년 10월 26일 게시한 소규모 로컬 시험 기록이다. 호출 단가는 10월 25일 확인값, 환율은 10월 16일의 1달러당 1,334.03원을 사용했다. 10월 28일에는 요약과 질문별 설명을 보완했으며, 실험을 다시 실행하거나 실제 청구서를 대조하지는 않았다.