
얼마나 덜 기다렸을까
약 26,700토큰의 같은 입력으로 첫 응답까지 걸린 시간을 비교했다.
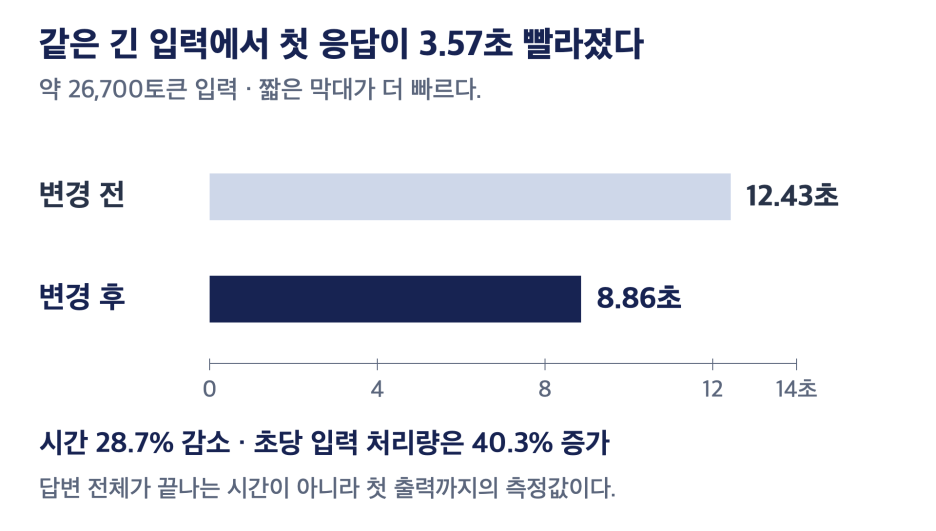
짧은 입력에서도 대기시간이 줄었다.
입력 길이 | 변경 전 첫 응답 | 변경 후 첫 응답 |
|---|---|---|
약 3,500토큰 | 1.60초 | 1.32초 |
약 26,700토큰 | 12.43초 | 8.86초 |
AI는 먼저 읽고 그다음 답을 쓴다
긴 문서를 붙여 넣고 질문하면 AI가 바로 답하지 않고 잠시 기다리게 된다.
입력을 읽고 답변을 준비하는 시간이 필요하기 때문이다. AI의 답변 과정을 두 단계로 나누면 이해하기 쉽다.
• 입력 읽기(prefill): 질문과 문서 내용을 처리한다.
• 답변 쓰기(decode): 출력 내용을 차례로 만들어 낸다.
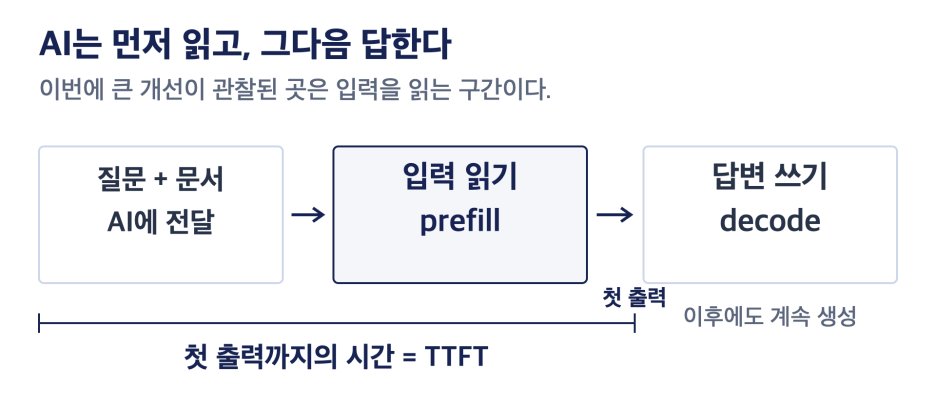
첫 출력이 나올 때까지의 시간을 TTFT라고 한다.
입력 읽기뿐 아니라 대기와 준비 시간도 포함할 수 있다.
이번에 큰 개선이 관찰된 곳은 입력 읽기 쪽이다.
참고로 토큰은 모델이 글을 나눠 처리하는 단위다.
한글 한 글자나 단어 하나와 정확히 같지는 않다.
한 번에 읽는 양은 늘리고 중간 계산은 나눴다
실험에서는 DeepSeek-V4.1-Flash를 DGX Spark 세 대에 나눠 실행했다.
실행을 관리하는 소프트웨어로는 SGLang을 사용했다.
바꾼 것은 두 가지다.
1. 한 번에 처리하는 입력 묶음을 768토큰에서 2,048토큰으로 늘렸다.
2. 입력의 관련성을 계산하는 내부 점수표를 작은 단위로 나눠 처리하는 코드를 적용했다.
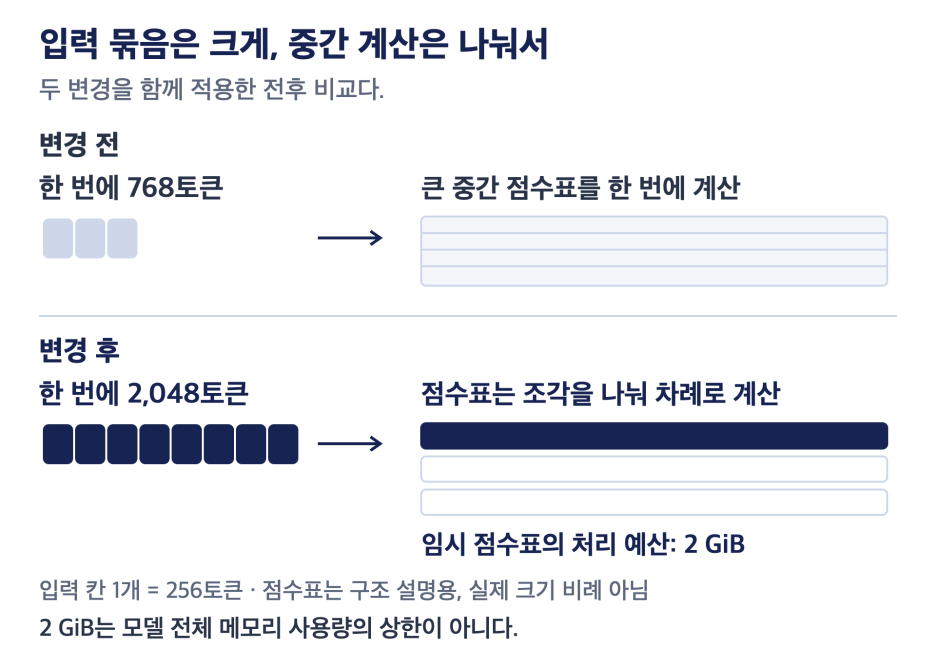
입력 묶음만 크게 하면 중간 계산에 필요한 메모리도 커질 수 있다.
보고서는 이 계산을 나누는 방식으로 메모리 부담을 줄여 더 큰 입력 묶음을 사용할 수 있게 했다고 설명한다.
비유하면 서류는 큰 묶음으로 가져오되 작업대에는 나눠 펼쳐 놓는 방식이다.
추가 검증
생성 속도, 긴 문서 속 정보 찾기, 다른 설정과의 비교는 아래에 따로 모았다.
답을 쓰는 속도의 변화는 더 작았다
다음은 답변 생성 속도다. 단위는 초당 생성 토큰 수이며 높을수록 빠르다.
동시에 처리한 요청 | 변경 전 | 변경 후 | 증가율 |
|---|---|---|---|
1개 | 46.71 | 48.29 | 3.4% |
4개 합계 | 100.57 | 106.58 | 6.0% |
8개 합계 | 139.48 | 149.3 | 7.0% |
이번 비교에서는 답변을 쓰는 속도보다, 긴 입력을 읽고 첫 출력을 기다리는 구간에서 더 큰 변화가 나타났다.
긴 입력에서도 필요한 정보를 찾았을까
속도만 빨라지고 필요한 내용을 놓치면 곤란하다.
보고서는 긴 검증용 문서 안에 특정 문구를 넣고 모델이 그 문구를 찾아 답하는 시험도 했다.
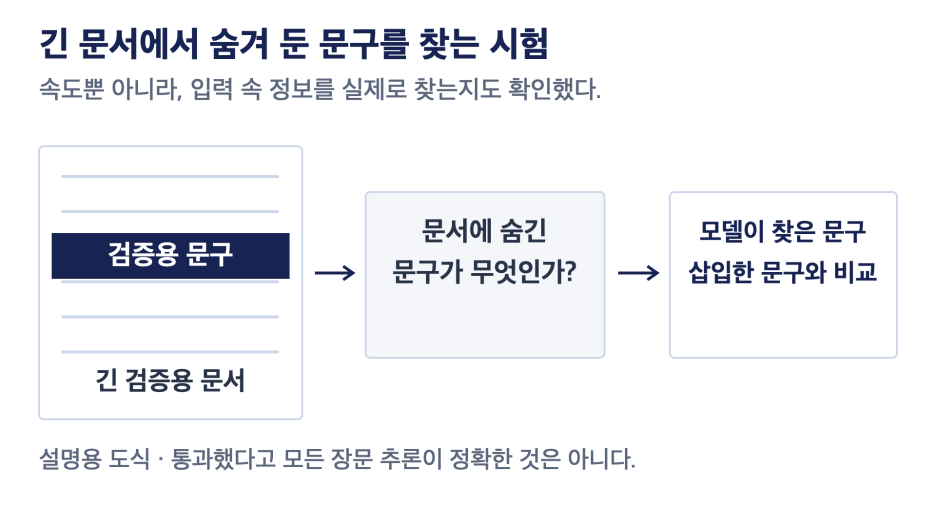
네 가지 입력 길이에서 모두 문구를 정확히 찾았다.
해당 시험 중 메모리 부족 오류도 발생하지 않았다.
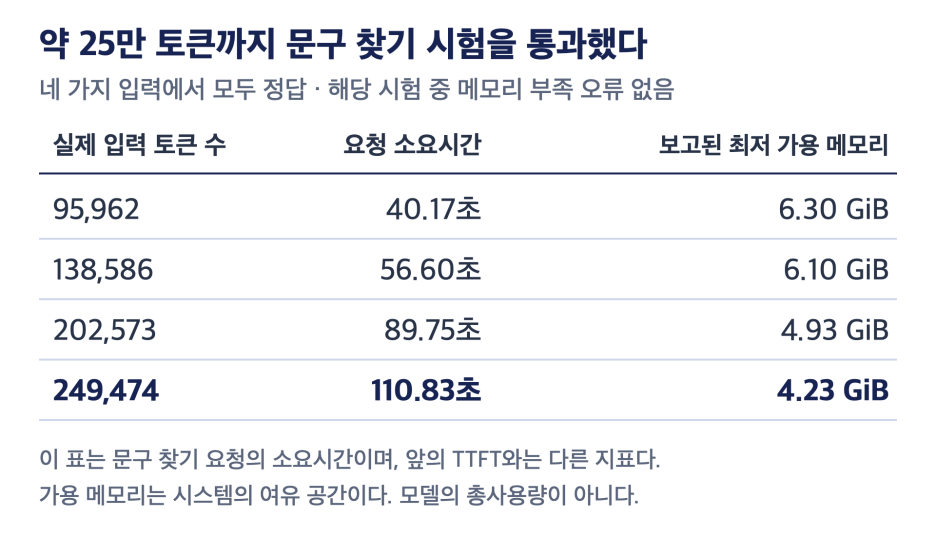
가장 긴 입력은 249,474토큰, 약 25만 토큰이었다.
이때 보고된 최저 가용 메모리는 4.23 GiB다.
이 표의 시간은 문구 찾기 요청의 소요시간이다. 앞에서 비교한 첫 응답 시간과는 다른 지표다.
다만 문구 찾기 시험을 통과했다고 해서 모든 장문 추론이 정확하다고 볼 수는 없다. 여러 요청을 동시에 넣거나 장시간 실행했을 때의 안정성까지 보장하지도 않는다.
더 크게, 더 새롭게 바꾸면 더 빨라질까
그렇지는 않았다. 입력 묶음을 4,096토큰으로 더 키우자 같은 긴 입력의 첫 응답이 8.86초에서 9.80초로 오히려 늦어졌다.
실험용 버전인 Canary도 재시도에서 정상 시작했다. 하지만 8개 동시 요청의 합산 속도는 좋아진 반면 코드 생성과 약 25만 토큰 작업은 느려졌다.
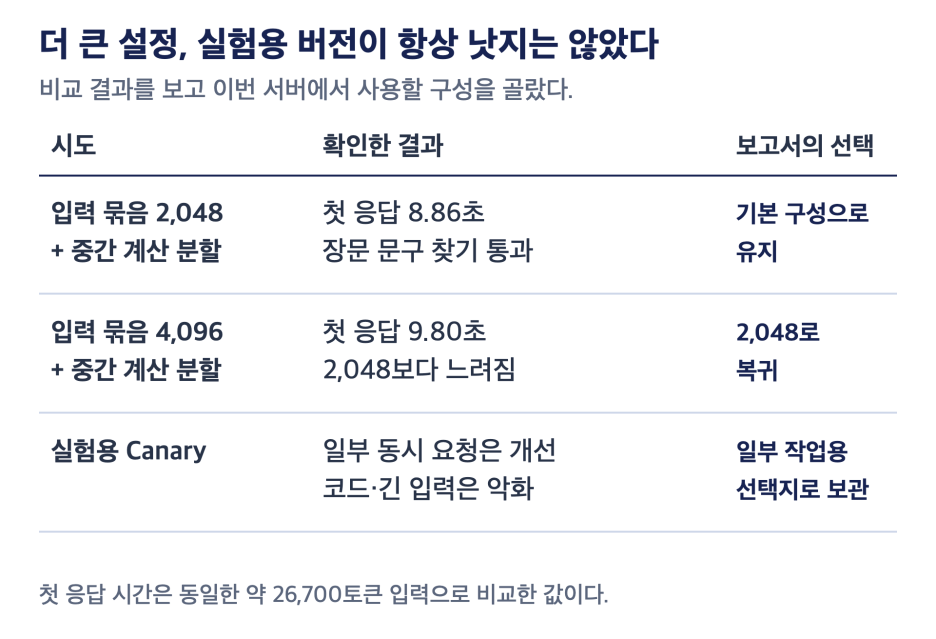
보고서의 최종 선택은 기존 사용 버전(stable)에 입력 묶음 2,048과 중간 점수표 분할을 적용한 구성이었다. Canary는 특정 작업을 위한 선택지로 남겼다.
정리하면
이 실험에서는 장비를 추가하지 않고 입력 묶음 확대와 중간 계산 분할을 함께 적용한 뒤, 긴 입력의 첫 응답 대기가 짧아졌다. 두 변경을 함께 적용한 전후 비교이므로 각각의 기여도는 이 결과만으로 분리할 수 없다. 더 큰 설정이나 실험용 버전이 모든 작업에서 유리한 것은 아니었다.
※ 수치는 2026년 10월 19일 직접 테스트한 특정 환경의 결과다. 10월 28일에는 설명과 FAQ를 보완했으며 추가 측정은 수행하지 않았다.
자주 묻는 질문
무엇을 바꿨고, 12.43초에서 8.86초로 줄어든 시간은 무엇인가요?
입력 묶음을 768토큰에서 2,048토큰으로 늘리는 변경과 중간 점수표를 나눠 계산하는 변경을 함께 적용했다. 12.43초와 8.86초는 같은 약 26,700토큰 입력에서 첫 출력까지 걸린 TTFT이며, 답변 전체가 끝나는 시간은 아니다. 두 설정을 함께 바꾼 전후 비교이므로 어느 변경이 얼마나 기여했는지는 분리할 수 없다.
답변을 생성하는 속도도 약 28.7% 빨라졌나요?
아니다. 약 28.7%는 긴 입력의 TTFT 감소율이다.
생성 속도는 단일 요청에서 46.71→48.29토큰/초(3.4% 증가), 동시 4개 요청 합계에서 100.57→106.58토큰/초(6.0%), 동시 8개 요청 합계에서 139.48→149.3토큰/초(7.0%)로 보고됐다.
4개·8개 값은 요청당 속도가 아닌 전체 요청의 합산 처리량이다. 공개 표에는 이 값들의 반복 횟수나 산술평균 여부가 명시돼 있지 않다.
약 25만 토큰 문구 찾기 통과는 무엇을 확인한 결과인가요?
입력 95,962·138,586·202,573·249,474토큰의 네 조건에서 삽입 문구를 모두 찾았고 해당 시험 중 메모리 부족 오류는 없었다는 기록이다. 가장 긴 조건의 요청 소요시간은 110.83초로 TTFT와 다른 지표이며, 보고된 최저 가용 메모리 4.23 GiB는 시스템 여유 공간이지 모델 총사용량이나 노드 전체 합산값으로 제시된 수치가 아니다. 일반적인 장문 추론 정확도나 지속 운영 안정성은 별도 검증이 필요하다.
기록 범위: 수치는 2026년 10월 19일 특정 환경의 테스트 기록이다. stable과 Canary는 당시의 버전 구분이다. 10월 28일에는 설명과 FAQ를 보완했으며, 새 측정이나 현재 운영 설정 확인을 수행한 것은 아니다.