
먼저 읽고 그다음 답을 쓴다
속도를 비교하기 전에 AI가 하는 일을 둘로 나눠 보면 쉽다. 질문과 문서를 읽는 단계가 Prefill, 답변을 써 내려가는 단계가 Decode다.
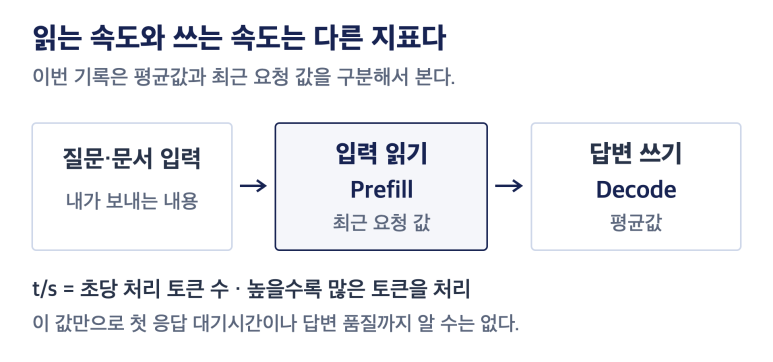
t/s는 초당 처리 토큰 수다. 토큰은 모델이 글을 나눠 처리하는 단위이며 한글 한 글자와 정확히 같지는 않다.
| 확인한 항목 | Windows | Mac |
|---|---|---|
| Decode 평균 · 답변 생성 | 122.7 t/s | 97.6 t/s |
| Prefill Last request · 최근 요청 입력 처리 | 264 t/s | 78 t/s |
두 행은 집계 기준도 다르다. Decode는 평균값이고 Prefill은 최근 요청에 표시된 값이다.
답변을 쓰는 평균 속도는 Windows가 높았다
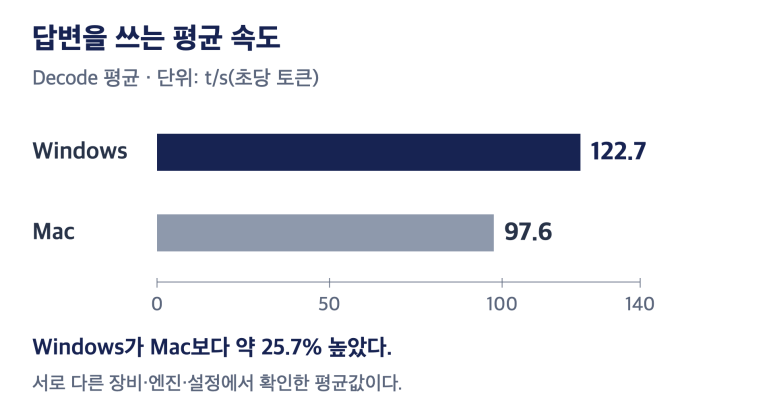
Mac의 97.6을 기준으로 계산하면 Windows의 122.7은 약 25.7% 높다. 이 값은 답변을 생성하는 처리량의 차이다.
다만 내가 채팅하면서 느낀 속도 차이는 수치 차이만큼 크지 않았다. 채팅 속도에 관한 체감일 뿐 답변 품질이 같다는 평가는 아니다.
최근 요청에서 입력을 읽는 속도
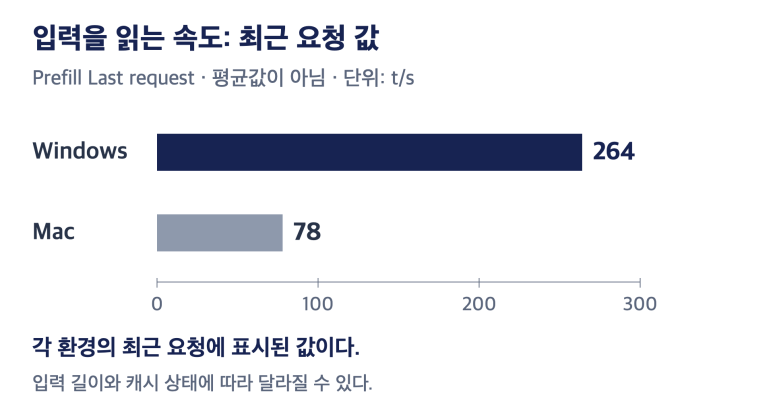
Prefill Last request는 Windows 264 t/s, Mac 78 t/s였다. 이번 요청에서 확인한 표시값이고 평균값은 아니다.
입력 길이와 캐시 상태에 따라 Prefill은 달라질 수 있다. 그래서 이 숫자를 긴 문서 처리의 평균 성능으로 보기는 어렵다. 첫 응답까지 몇 초가 걸렸는지도 이 수치만으로는 알 수 없다.
실행 환경도 함께 봐야 한다
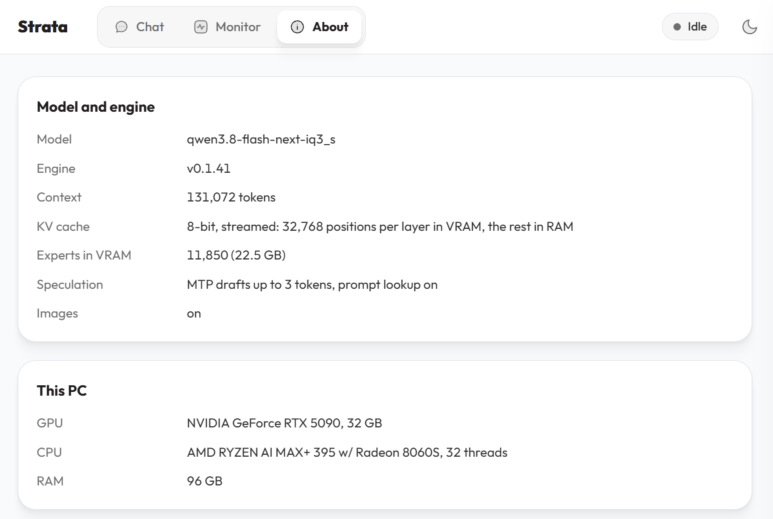
두 About 화면의 모델명은 qwen3.8-flash-next-iq3_s로 같았다. 아래 사진은 속도 측정 화면이 아니라 당시 장비와 설정을 기록한 화면이다.
Windows 실행 화면
Mac 실행 화면
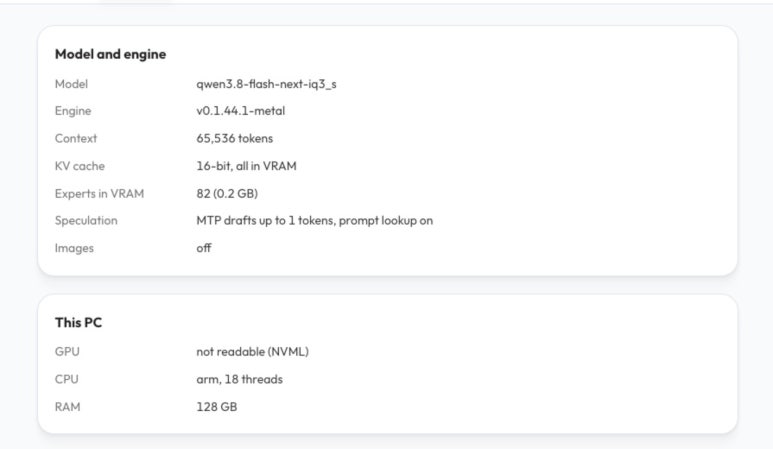
| 항목 | Windows | Mac |
|---|---|---|
| 엔진 버전 | v0.1.41 | v0.1.44.1-metal |
| CPU 화면 표시 | Ryzen AI MAX+ 395, 32스레드 | ARM, 18스레드 |
| GPU 화면 표시 | NVIDIA GeForce RTX 5090, 32GB | not readable (NVML) |
| RAM | 96GB | 128GB |
| 설정된 컨텍스트 | 131,072토큰 | 65,536토큰 |
| KV 캐시 | 8-bit, 일부 VRAM·나머지 RAM | 16-bit, all in VRAM 표시 |
| MTP 초안 상한 | 최대 3토큰 | 최대 1토큰 |
| 이미지 입력 설정 | 켜짐 | 꺼짐 |
컨텍스트는 한 번에 다루도록 설정한 텍스트 범위다. 표의 숫자는 이번 설정값이며 각 OS의 최대 지원치가 아니다. MTP도 다음 토큰을 미리 예측해 검사하는 기능의 설정이며 초안 상한을 초당 속도로 읽으면 안 된다.
하드웨어뿐 아니라 엔진 버전과 캐시·실행 옵션도 달랐다. 이번 결과에서 OS만의 영향을 따로 분리할 수는 없다.
Mac 화면에서 주의할 부분
GPU 항목의 not readable (NVML)만으로는 GPU 미사용이라고 볼 수 없다. 저장소의 Mac 문서는 Apple Silicon에서 Metal 엔진을 사용하는 경로를 안내한다.
Experts in VRAM의 82개·0.2GB 역시 모델 전체 메모리 사용량과는 다른 값이다. Mac의 통합 메모리와 특정 캐시 항목의 표시는 Windows의 전용 VRAM 점유량과 단순 비교하기 어렵다.
이미지 입력은 이번 Mac 실행에서 off였다. 공식 Mac 문서에는 켜는 옵션도 있으므로 Mac이 이미지 입력을 지원하지 않는다는 뜻은 아니다.
정리하면
내가 사용한 두 구성에서는 Windows의 평균 답변 생성 속도가 더 높았지만 채팅 체감 차이는 크지 않았다. Prefill은 최근 요청 값이라 평균과는 집계 기준이 다르다.
이 글은 서로 다른 장비·엔진·설정에서 사용한 기록이다. 더 엄밀한 비교에는 같은 질문과 출력 길이, 캐시 조건을 맞춘 반복 측정이 필요하다.
자주 묻는 질문
Strata는 Windows가 Mac보다 빠른가?
이 글의 두 구성에서는 Decode 평균 표시값이 Windows 122.7 t/s, Mac 97.6 t/s였다. 장비·엔진·컨텍스트·KV 캐시·MTP 조건이 달라 Windows가 항상 빠르다는 결론은 아니다.
Prefill 수치로 첫 응답 시간을 알 수 있나?
아니다. Prefill Last request 264 t/s와 78 t/s는 최근 요청의 입력 처리량이다. 입력 길이·캐시 조건과 실제 첫 토큰까지 걸린 시간을 함께 측정해야 한다.
Mac의 not readable (NVML)은 GPU 미사용을 뜻하나?
그 표시만으로 GPU 미사용을 판단할 수 없다. Strata의 Mac 실행 문서는 Apple Silicon의 Metal 경로를 안내한다. 이 글에 기록한 Mac의 정확한 칩명은 화면에서 확인되지 않았다.
작성: 얼라이엑스(Allaix). 2026. 10. 28. 제목·요약·질문별 설명을 보완했다. 새로운 성능 측정을 추가한 것은 아니다.
자료와 참고 문서
자료: 채팅 테스트에서 확인한 속도와 About 화면. Mac의 정확한 칩명은 화면에서 확인되지 않았다.
참고 문서: