
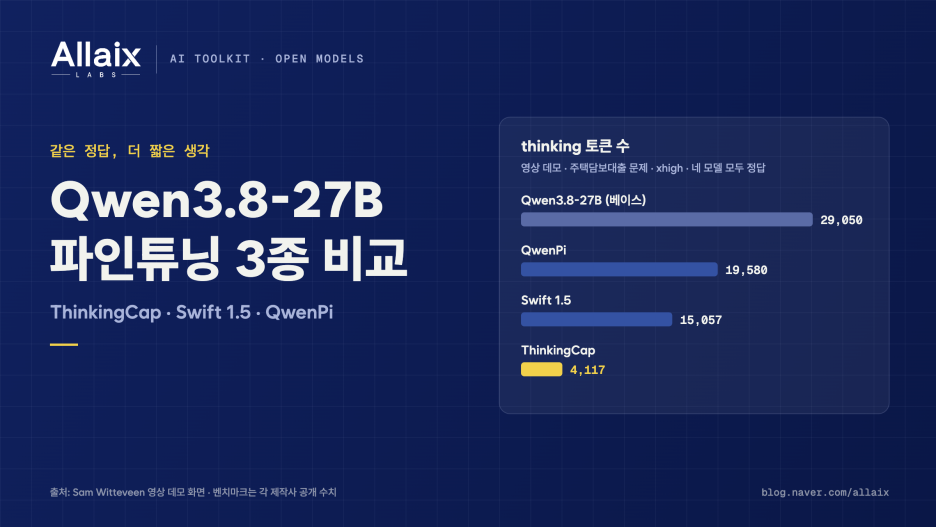
Sam Witteveen은 10월 4일(미국 시간) 올린 영상 「Which is The Best Qwen3.8-27B?」에서 이 가운데 세 모델을 나란히 돌려 봤다. 이 글은 영상 내용을 각 제작사의 모델 카드, 공식 블로그와 하나씩 대조해 정리한 것이다.
이 글에서 인용한 벤치마크 숫자는 각 제작자가 공개한 측정값이다. 이번 글은 이를 독립적으로 재현하지 않았으며, 외부의 모든 독립 재현 여부까지 확인한 것은 아니다.
세 줄 요약 ThinkingCap 기본 설정(xhigh) 그대로 바꿔 끼우는 범용 모델. 12개 벤치마크 평균 생각 토큰 37.2% 감소, 정확도 0.86%p 하락 Swift 1.5 코딩과 에이전트 작업에 무게를 둔 모델. LiveCodeBench 76.76% → 81.71%, 토큰 24.5% 감소 QwenPi Pi 코딩 에이전트의 작업 흐름에 맞춘 모델. medium 설정으로 베이스 xhigh와 같은 Terminal-Bench 완료율, 출력 토큰 약 41% 감소 |
01 왜 생각 토큰을 줄이려 하나
Qwen3.8-27B는 reasoning effort를 low, medium, xhigh 세 단계로 고를 수 있다. 기본값은 가장 오래 생각하는 xhigh다.
영상 첫 장면이 그 차이를 잘 보여 준다. 같은 문제를 ThinkingCap은 803토큰, 18.4초 만에 풀었고 베이스 모델은 5,035토큰을 쓰며 1분 30초가 걸렸다.
둘 다 맞혔다면 생각을 덜 한 쪽이 같은 GPU로 더 많은 요청을 받아 낸다.
세 모델이 노리는 지점은 조금씩 다르다. 영상은 ThinkingCap과 Swift를 xhigh의 긴 생각을 줄이는 쪽으로, QwenPi를 low·medium 설정을 쓸 만하게 만드는 쪽으로 소개한다.
02 세 모델 한눈에 보기
항목 | ThinkingCap | Swift 1.5 | QwenPi |
|---|---|---|---|
만든 곳 | BottleCap AI (체코 프라하) | UkisAI | bytkim (개인 개발자) |
방식 | 지식·말투 유지와 생각 토큰 감소를 목표로 함 | 과잉 사고 토큰에 페널티, 정확도는 RL·온폴리시 증류로 회복 | 검증된 Pi 코딩 세션으로 SFT, GRPO 기반 RL에 추론 효율 보상 |
대표 수치 (제작사 측정) | 12개 벤치 평균 생각 토큰 -37.2%, 정확도 -0.86%p | 벤치별 평균 생각 토큰 -16~54%, GPQA 정확도 유지 | Terminal-Bench 2.1에서 medium이 베이스 xhigh와 같은 완료율, 출력 토큰 -41% |
라이선스 | PolyForm Small Business 1.0.0 + 개인 사용 허용 | Swift Open License v1.0 | Apache 2.0 |
잘 맞는 용도 | 범용 (xhigh 설정으로 교체·비교) | 코딩, 에이전트 | Pi 기반 코딩 에이전트 |
03 ThinkingCap (BottleCap AI)
BottleCap AI는 체코 프라하의 연구소로, word2vec을 만든 토마시 미콜로프(Tomáš Mikolov)가 공동 창업했다.
ThinkingCap 제작자가 밝힌 목표는 베이스 성능을 최대한 유지하면서 생각 토큰을 줄이는 것이다. 모든 문제에서 정답률이 같다는 뜻은 아니며, 공개 평가에서도 벤치마크별 정확도 상승과 하락이 함께 나타난다.
제작사는 베이스 모델과 같은 하네스, 같은 서빙 설정(vLLM 0.29.0, H200 1장, xhigh)으로 12개 벤치마크를 쟀다. 아래 표는 그중 8개와 12개 평균이다.
벤치마크 | 베이스 | ThinkingCap | 정확도 변화 | 생각 토큰 |
|---|---|---|---|---|
AIME 2026 (수학 경시) | 98.13% | 94.27% | -3.85%p | -30.2% |
GPQA-Diamond (과학) | 89.93% | 88.04% | -1.89%p | -43.1% |
LiveCodeBench v6 (코딩) | 91.14% | 91.21% | +0.07%p | -20.3% |
MMLU-Pro (지식) | 85.54% | 84.67% | -0.86%p | -57.3% |
MMMLU (다국어 지식) | 85.38% | 84.09% | -1.29%p | -65.5% |
AA-LCR (긴 문서 추론) | 81.75% | 84.00% | +2.25%p | -38.6% |
τ²-bench (멀티턴 에이전트) | 76.16% | 75.15% | -1.01%p | -30.9% |
Terminal-Bench 2.1 (터미널 에이전트) | 75.84% | 75.28% | -0.56%p | -10.7% |
12개 평균 | 86.65% | 85.79% | -0.86%p | -37.2% |
37.2%는 벤치마크별 감소율을 단순 평균한 값이다. 표에 함께 나온 평균 생각 토큰 수(15,735 → 12,144)로 계산하면 감소율은 22.8%로 내려간다. 토큰을 많이 쓰는 벤치마크일수록 덜 줄었다는 뜻이다.
에이전트가 터미널에서 일하는 Terminal-Bench는 10.7%밖에 줄지 않았다. AIME 2026은 정확도가 3.85%p 떨어졌으니 수학 경시 수준의 정답률이 중요하면 베이스가 낫다.
측정 조건에도 단서가 붙는다. MMMLU는 전체가 아닌 1만 문항 표본이었고 MMLU-Pro와 MMMLU는 시드 하나로만 쟀다고 모델 카드에 적혀 있다.
배포 형태는 다양하다. BF16 원본 외에 FP8(31GB), 가중치만 4비트로 줄인 NVFP4(21GB, Hopper·Blackwell), NVFP4A4(23GB, Blackwell 전용), GGUF, 애플 실리콘용 MLX까지 나와 있다.
제작사는 MTP 추측 디코딩의 채택 길이가 베이스와 비슷하다고 보고한다. 다만 토큰 감소율이 실제 응답 시간이나 처리량 개선율과 같다는 뜻은 아니다. 디코더 설정·하드웨어·배치와 작업 유형을 맞춘 별도 시간 측정이 필요하다.
04 Swift 1.5 (UkisAI)
Swift 1.5는 과잉 사고와 연결된 토큰을 골라 페널티를 준다. 그 과정에서 떨어진 정확도는 강화학습(RL)과 온폴리시 증류(OPD)로 되살렸다.
제작사는 장기 에이전트 작업과 코딩에 무게를 뒀다고 설명한다. 이전 버전인 Swift 1.0에는 ThinkingCap-Qwen3.6-27B에서 가져온 전이 요소가 들어 있다.
측정 조건은 BF16, vLLM 0.27.1, xhigh, 5회 반복 평균이다.
벤치마크 | 베이스 | Swift 1.5 | 평균 토큰 | 중앙값 토큰 |
|---|---|---|---|---|
GPQA-Diamond | 88.28% | 88.59% | -41.9% | -58.5% |
C-Eval (중국어) | 90.00% | 90.92% | -45.1% | -16.9% |
IFBench (지시 이행) | 73.53% | 72.07% | -38.5% | -47.3% |
ERQA (체화 추론) | 67.45% | 65.40% | -53.9% | -56.2% |
AIME 2026 | 98.67% | 96.00% | -40.0% | -48.5% |
HMMT 2025-11 | 99.33% | 97.33% | -32.1% | -47.8% |
LiveCodeBench v6 | 76.76% | 81.71% | -24.5% | -46.3% |
Terminal-Bench 2.1 | 69.21% | 72.13% | -16.3% | -0.1% |
홍보 문구의 "최대 58.5% 감소"는 GPQA의 중앙값 기준이다. 평균으로 보면 벤치마크마다 16~54% 줄었다.
low 설정에서 베이스보다 높은 점수를 29% 적은 토큰으로 냈다는 결과도 GPQA-Diamond 하나에서 나왔다. medium에서는 오히려 베이스보다 점수가 낮았다(84.14% → 82.22%).
ERQA는 구글 딥마인드가 만든 체화(embodied) 추론 벤치마크로, 이미지를 보고 푸는 문제다.
UkisAI는 연구용 무료 API(https://ukisai.com/api/swift/v1, 모델 id swift)도 열어 뒀다. API 키 없이 바로 호출되지만 1.0과 1.5 중 어느 가중치가 응답하는지는 표시되지 않는다.
05 QwenPi (bytkim)
QwenPi는 오픈소스 터미널 코딩 에이전트 Pi(pi.dev, Mario Zechner 제작, MIT 라이선스)의 작업 흐름에 맞춰 파인튜닝한 모델이다. Pi에 맞췄다는 설명은 다른 하네스에서 실행할 수 없다는 의미가 아니며, 공개 성과의 적용 범위는 측정에 사용한 하네스로 한정해 읽어야 한다. 학생 개발자 Thomas Kim(bytkim)이 사비로 GPU를 빌려 학습했다.
학습은 두 단계다. 검증을 통과한 Pi 코딩 세션으로 LoRA 기반 SFT를 하고 GRPO 기반 RL에 추론 효율 보상을 붙였다.
체크포인트는 학습 손실만 보고 고르지 않았다. 완료율, 토큰 수, 툴 호출, 소요 시간 같은 실제 에이전트 결과를 함께 따졌다.
Terminal-Bench 2.1에서 QwenPi는 medium 설정만으로 베이스 xhigh와 같은 완료율(89개 중 67개)을 냈다. 출력 토큰은 약 41% 적었다.
평가 (Pi 하네스) | 베이스 | QwenPi | 비고 |
|---|---|---|---|
Terminal-Bench 2.1 | xhigh 75.28% | medium 75.28% | 출력 토큰 약 41% 감소 |
Terminal-Bench 2.1 | xhigh 75.28% | xhigh 79.78% | 토큰 약 12% 감소 |
SciCode 자체 과제 묶음 | xhigh 45.4% | xhigh 48.4% | 토큰 약 23% 감소 |
GPQA-Diamond | xhigh 80.93% | xhigh 86.36% | QwenPi 우세 |
GPQA-Diamond | medium 84.72% | medium 83.71% | 베이스 우세 |
SciCode 과제 묶음은 제작자가 따로 꾸린 것(과제 80개, 하위 문제 337개)으로 공식 SciCode 평가 방식이 아니다.
제작기는 공개한 Pi 평가에 FP8 가중치를 사용했다고 명시한다. 이 절의 수치는 Pi 하네스 조건으로 읽어야 하며, 여기서 인용한 공개 평가에는 LiveCodeBench 결과가 없다. RL을 시드 하나로 짧게 돌렸고 전체 벤치마크를 반복 측정하지 못했다는 한계도 제작자가 직접 적어 뒀다.
06 영상 데모로 본 차이
영상 후반부에서는 베이스까지 네 모델에 같은 프롬프트를 넣고 나란히 돌린다. 난이도는 hard, effort는 xhigh다.
화면의 16x는 녹화를 빨리 돌린 재생 속도다. 표에 적은 시간은 실제 생성 시간이다(토큰 수를 초당 토큰으로 나누면 거의 맞는다).
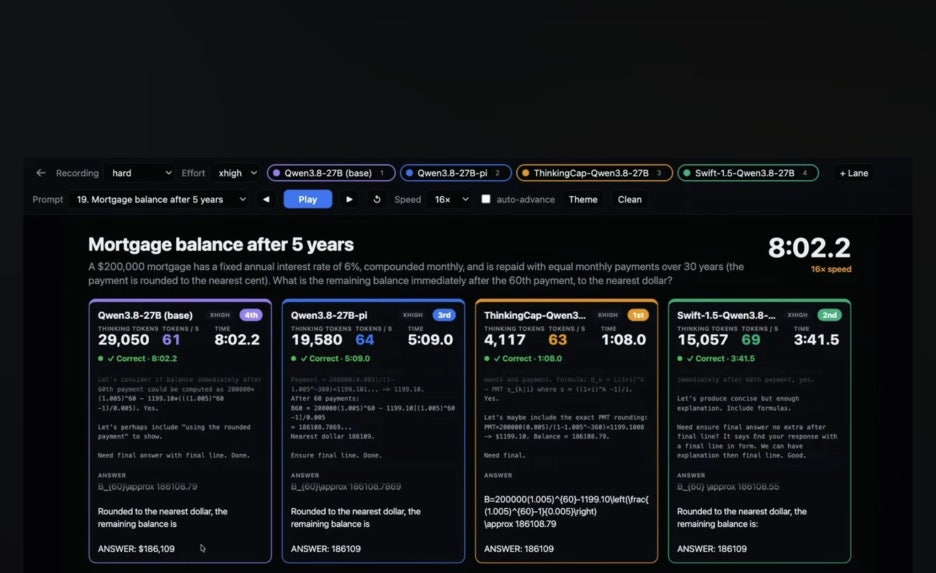
5년 뒤 주택담보대출 잔액 | 생각 토큰 | 시간 |
|---|---|---|
Qwen3.8-27B (베이스) | 29,050 | 8:02.2 |
QwenPi | 19,580 | 5:09.0 |
Swift 1.5 | 15,057 | 3:41.5 |
ThinkingCap | 4,117 | 1:08.0 |
네 모델 모두 정답($186,109)을 냈다. ThinkingCap은 베이스보다 생각 토큰을 86% 덜 쓰고 약 7배 빨랐다.
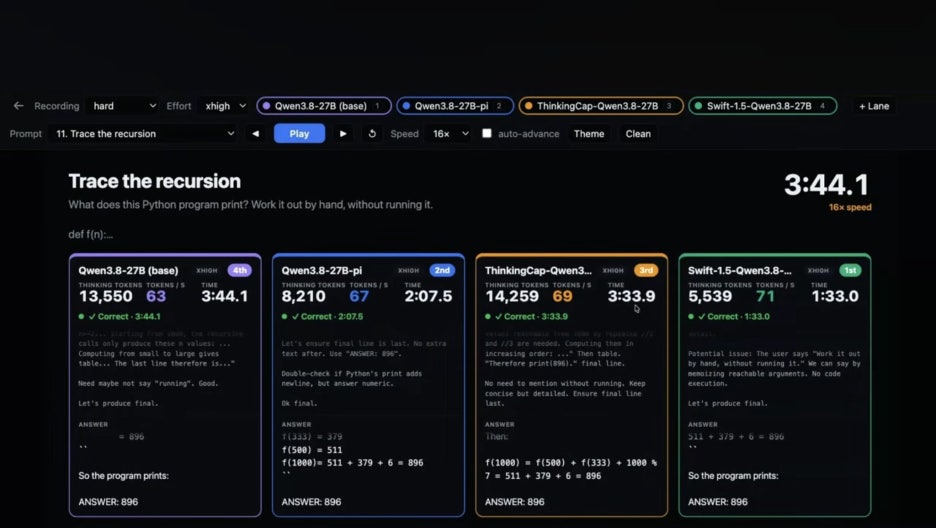
재귀 함수 출력 맞히기 | 생각 토큰 | 시간 |
|---|---|---|
Qwen3.8-27B (베이스) | 13,550 | 3:44.1 |
QwenPi | 8,210 | 2:07.5 |
ThinkingCap | 14,259 | 3:33.9 |
Swift 1.5 | 5,539 | 1:33.0 |
이번에도 네 모델 모두 896으로 맞혔다. 그런데 ThinkingCap은 베이스보다 생각을 더 길게 했다. 같은 모델이라도 문제에 따라 절감 폭이 크게 달라진다.
영상에는 참고할 장면이 두 개 더 있다. 코딩과 SVG 문제에서는 Swift 1.5가 가장 빨랐다.
주택담보대출 문제를 medium으로 다시 돌렸을 때는 QwenPi가 2:37.9로 가장 빨랐고 베이스(2:58.4)가 ThinkingCap(3:23.6)을 앞섰다. xhigh에 맞춰 생각을 줄인 모델은 medium에서 이점이 사라질 수 있다.
데모는 Dell이 후원한 Dell Pro Max 타워(RTX Pro 6000)에서 돌렸고 vLLM은 따로 최적화하지 않았다.
07 숫자를 읽을 때 주의할 점
벤치마크는 모두 제작사가 잰 값이다. 영상도 모델 카드 수치를 인용했을 뿐 다시 측정하지 않았다.
제작사끼리 숫자를 맞대는 것도 피해야 한다. 같은 베이스 모델인데 측정한 곳마다 점수가 크게 다르다.
측정한 곳 | 베이스 GPQA-Diamond | 베이스 LiveCodeBench v6 |
|---|---|---|
BottleCap AI | 89.93% | 91.14% |
UkisAI | 88.28% | 76.76% |
QwenPi 제작자 (Pi 하네스) | 80.93% | 공개 수치 없음 |
하네스와 설정이 다르니 각 표는 자기 베이스 대비 변화로만 읽어야 한다. 영상 데모도 프롬프트 몇 개의 결과라 경향을 보는 정도로 쓰는 게 맞다.
08 회사에서 쓰려면 라이선스부터
모델 | 라이선스 | 상업적 이용 |
|---|---|---|
ThinkingCap | PolyForm Small Business 1.0.0 + 개인 사용 허용 | 직원·계약자 100명 미만, 연 매출 100만 달러(2019년 달러 기준) 미만 소규모 사업자만 가능. 더 큰 기업은 BottleCap과 별도 상용 계약 |
Swift 1.5 | Swift Open License v1.0 | 계열사 포함 연 매출 100만 달러를 경계로 한 상업 이용 조건이 있음. 정확한 경계 적용은 LICENSE와 Enterprise 계약 확인 |
QwenPi | Apache 2.0 | 셋 중 제약이 가장 적음 |
ThinkingCap의 이전 Qwen3.6 기반 버전은 Apache 2.0이었다. Swift 1.5의 BF16 원본은 허깅페이스에서 접근 승인을 받아야 내려받을 수 있다.
베이스인 Qwen3.8-27B는 Apache 2.0이지만 파인튜닝 모델에는 각 제작사의 라이선스가 따로 붙는다.
09 직접 돌려 보려면
세 모델 모두 베이스와 구조가 같아 vLLM에서 모델 경로만 바꿔 시험할 수 있다. reasoning parser는 qwen3이고 effort는 xhigh(기본), medium, low 중에서 고른다.
아래는 Swift 1.5 모델 카드에 나온 vLLM 실행 예시다.
vllm serve ukisai/Swift-1.5-Qwen3.8-27b \
  --dtype bfloat16 --tensor-parallel-size 1 \
  --max-model-len 262144 --reasoning-parser qwen3 \
  --enable-auto-tool-choice --tool-call-parser qwen3_coder
GPU 메모리가 빠듯하면 FP8(30GB 안팎)이나 NVFP4(20GB대) 빌드부터 보면 된다. DGX Spark(GB10) 같은 Blackwell 계열은 FP4를 하드웨어에서 지원한다. 다만 vLLM의 NVFP4 커널 지원 수준이 장비마다 달라 실제 속도는 직접 재 봐야 한다.
평가할 때는 정답률만 보지 말고 effort 단계별 생각 토큰, 응답 시간, 처리량을 함께 기록해 두자. 데모에서 봤듯 베이스의 medium이 파인튜닝 모델보다 빠를 때도 있다.
10 얼라이엑스의 정리
세 모델 모두 같은 답을 더 짧게 내겠다는 방향은 뚜렷하다. 제작사 수치와 영상 데모에서도 체감할 만한 차이가 보인다.
다만 절감 폭은 문제 유형과 effort 설정에 따라 크게 흔들린다. 도입 전에 실제 업무 프롬프트로 다시 재 보는 과정은 건너뛰지 않는 편이 좋다.
용도별로 고른다면 ThinkingCap 범용 질의응답·분석을 xhigh 품질 유지와 생각 토큰 감소를 목표로 비교 (라이선스 조건 확인 필수) Swift 1.5 코딩·에이전트 작업이 중심 QwenPi Pi 에이전트를 쓰거나 low·medium의 출력 토큰 효율을 비교하려면 |
얼라이엑스는 오픈 모델 선정부터 사내 환경 구축, 실제 업무 데이터로 돌리는 자체 벤치마크 설계까지 함께한다. 문의는 allaixlabs@gmail.com으로 받는다.
자주 묻는 질문
ThinkingCap·Swift 1.5·QwenPi 중 무엇이 가장 좋은가요?
공개 자료만으로 단일 1위를 정할 수 없다. ThinkingCap은 xhigh의 범용 효율을, Swift 1.5는 코딩·장기 에이전트 작업을, QwenPi는 Pi 작업 흐름과 effort별 효율을 겨냥한다. 같은 베이스도 제작자별 점수가 다르므로 실제 용도·하네스·effort·정밀도를 맞춰 베이스와 각각 비교해야 한다. QwenPi가 Pi 외 환경에서는 실행 불가능하다는 뜻도 아니다.
토큰 37.2%·58.5%·41% 감소를 그대로 속도나 비용 절감으로 봐도 되나요?
아니다. ThinkingCap의 37.2%는 12개 벤치마크별 생각 토큰 감소율의 단순 평균이며, 표의 평균 토큰 수 15,735→12,144 비율로는 약 22.8%다.
Swift의 58.5%는 GPQA-Diamond 중앙값 감소이고,
QwenPi의 약 41%는 제작자의 Pi 하네스 Terminal-Bench 2.1에서 FP8 Pi medium과 베이스 xhigh가 각각 67/89를 푼 조건의 출력 토큰 감소다.
벽시계 시간·처리량·청구액과 동일한 지표가 아니다.
베이스가 Apache 2.0이면 세 파인튜닝 모델도 회사에서 자유롭게 쓸 수 있나요?
그렇지 않다. ThinkingCap은 PolyForm Small Business 1.0.0과 개인 비상업 사용 허용, Swift 1.5는 Swift Open License v1.0의 상업 이용 매출 조건을 따로 확인해야 한다. QwenPi는 모델 카드에서 Apache 2.0으로 안내된다. 베이스의 권리가 파인튜닝 기여분의 별도 조건을 없애지는 않으며, 정확한 적용 여부는 내려받는 버전의 LICENSE·NOTICE와 별도 계약을 확인해야 한다.
참고 자료
영상: Sam Witteveen, 「Which is The Best Qwen3.8-27B?」 https://www.youtube.com/watch?v=2RA7jWJvQ1U
ThinkingCap 블로그: https://bottlecapai.com/post/thinkingcap-qwen3-8-27b/
ThinkingCap 모델 카드: https://huggingface.co/bottlecapai/ThinkingCap-Qwen3.8-27B
Swift 1.5: https://ukisai.com/swift-1-5-27b
Swift 1.5 모델 카드: https://huggingface.co/ukisai/Swift-1.5-Qwen3.8-27b
QwenPi 모델 카드: https://huggingface.co/bytkim/Qwen3.8-27B-pi
QwenPi 제작기: https://huggingface.co/blog/bytkim/qwen38-27b-pi
2026년 10월 5일 기준으로 각 출처를 직접 확인했다. 숫자는 제작사 공개값이라 모델 카드가 바뀌면 달라질 수 있다.
기록 범위: 2026년 10월 5일 확인한 제작자 자료와 영상 데모를 구분해 정리한 글이다. 10월 28일에는 문서 표현과 FAQ를 보완했으며, 모델 추론·벤치마크·영상 데모를 다시 실행하지 않았다. 실제 도입 전에는 사용할 가중치 버전과 라이선스, 하네스·정밀도·effort를 다시 확인한다.